

Eine KI-ready Website ist eine Website, die KI-Systeme wie ChatGPT, Perplexity und Google AI Overviews technisch erreichen, inhaltlich verstehen und als Quelle zitieren können. Dafür braucht es vier Dinge: Crawler dürfen und können eure Seiten lesen, die Inhalte sind klar strukturiert, Fakten liegen maschinenlesbar vor, und eure Marke ist als vertrauenswürdige Entität erkennbar.
Gute Rankings bei Google decken davon nur einen Teil ab. Für unsere eigene GEO-Checkliste haben wir bei Friendventure 40 Prüfpunkte in fünf Handlungsfeldern zusammengetragen. Die technischen davon, also alles, was direkt an der Website hängt, stecken in diesem Artikel. Ihr bekommt hier eine Checkliste, mit der ihr eure Website selbst prüfen und die Aufgaben direkt an eure IT oder Agentur weitergeben könnt.
Was „KI-ready“ bei einer Website wirklich bedeutet
KI-ready heißt: Eure Website wird in KI-Antworten als Quelle genutzt. Klassisches SEO sorgt dafür, dass ihr in einer Trefferliste rankt. Eine KI-ready Website sorgt dafür, dass ChatGPT oder Perplexity eure Inhalte lesen, richtig einordnen und in ihre Antwort übernehmen.
Für diese Disziplin gibt es zwei Namen. Generative Engine Optimization (GEO) meint die Optimierung für Systeme, die Antworten selbst formulieren. Einen guten Überblick liefert der bakedwith-Glossareintrag zu Generative Engine Optimization (GEO). Answer Engine Optimization (AEO) beschreibt fast dasselbe mit Blick auf Antwortmaschinen. Für eure Website ist der Unterschied zweitrangig, denn die technischen Grundlagen sind identisch.
Die folgende Tabelle zeigt, wo sich die beiden Ansätze unterscheiden:
GEO baut auf SEO auf. Eine technisch fehlerhafte Website bekommt auch keine KI-Sichtbarkeit.
Warum KI-Sichtbarkeit 2026 über Leads entscheidet
Im B2B-Einkauf beginnt die Recherche immer öfter im KI-Chat, und wer dort fehlt, landet nicht auf der Shortlist. Gleichzeitig bringen Besuche aus KI-Antworten überdurchschnittlich viele Anfragen. Beides zusammen macht KI-Sichtbarkeit zu einem Vertriebsthema.
Zwei Zahlen zeigen die Richtung. Für den Report „The Answer Economy“ von G2 wurden im März 2026 über 1.000 B2B-Softwareeinkäufer befragt. 51 Prozent davon starten ihre Recherche inzwischen häufiger in einem KI-Chatbot als bei Google. Und eine Studie von Semrush über mehr als 500 Themen aus Digitalmarketing und SEO kommt zu dem Ergebnis, dass ein Besuch aus der KI-Suche gemessen an der Conversion-Rate im Schnitt 4,4-mal so wertvoll ist wie ein Besuch aus der klassischen organischen Suche.
Wer über eine KI-Antwort kommt, hat den Markt schon sortiert bekommen und klickt gezielt. Für eure Website heißt das, dass wenige Besuche aus ChatGPT oder Perplexity mehr wert sein können als viele aus der Google-Suche.
Ein Top-Ranking schützt euch dabei nur bedingt. KI-Systeme stützen sich zwar oft auf Suchindizes, wählen ihre Quellen aber nach eigenen Kriterien aus. Eine Seite auf Platz 2 bei Google kann in der KI-Antwort fehlen, wenn ihre Kernaussage im fünften Absatz versteckt ist oder der Crawler sie gar nicht abrufen darf.
Wie KI-Suchmaschinen eure Website lesen
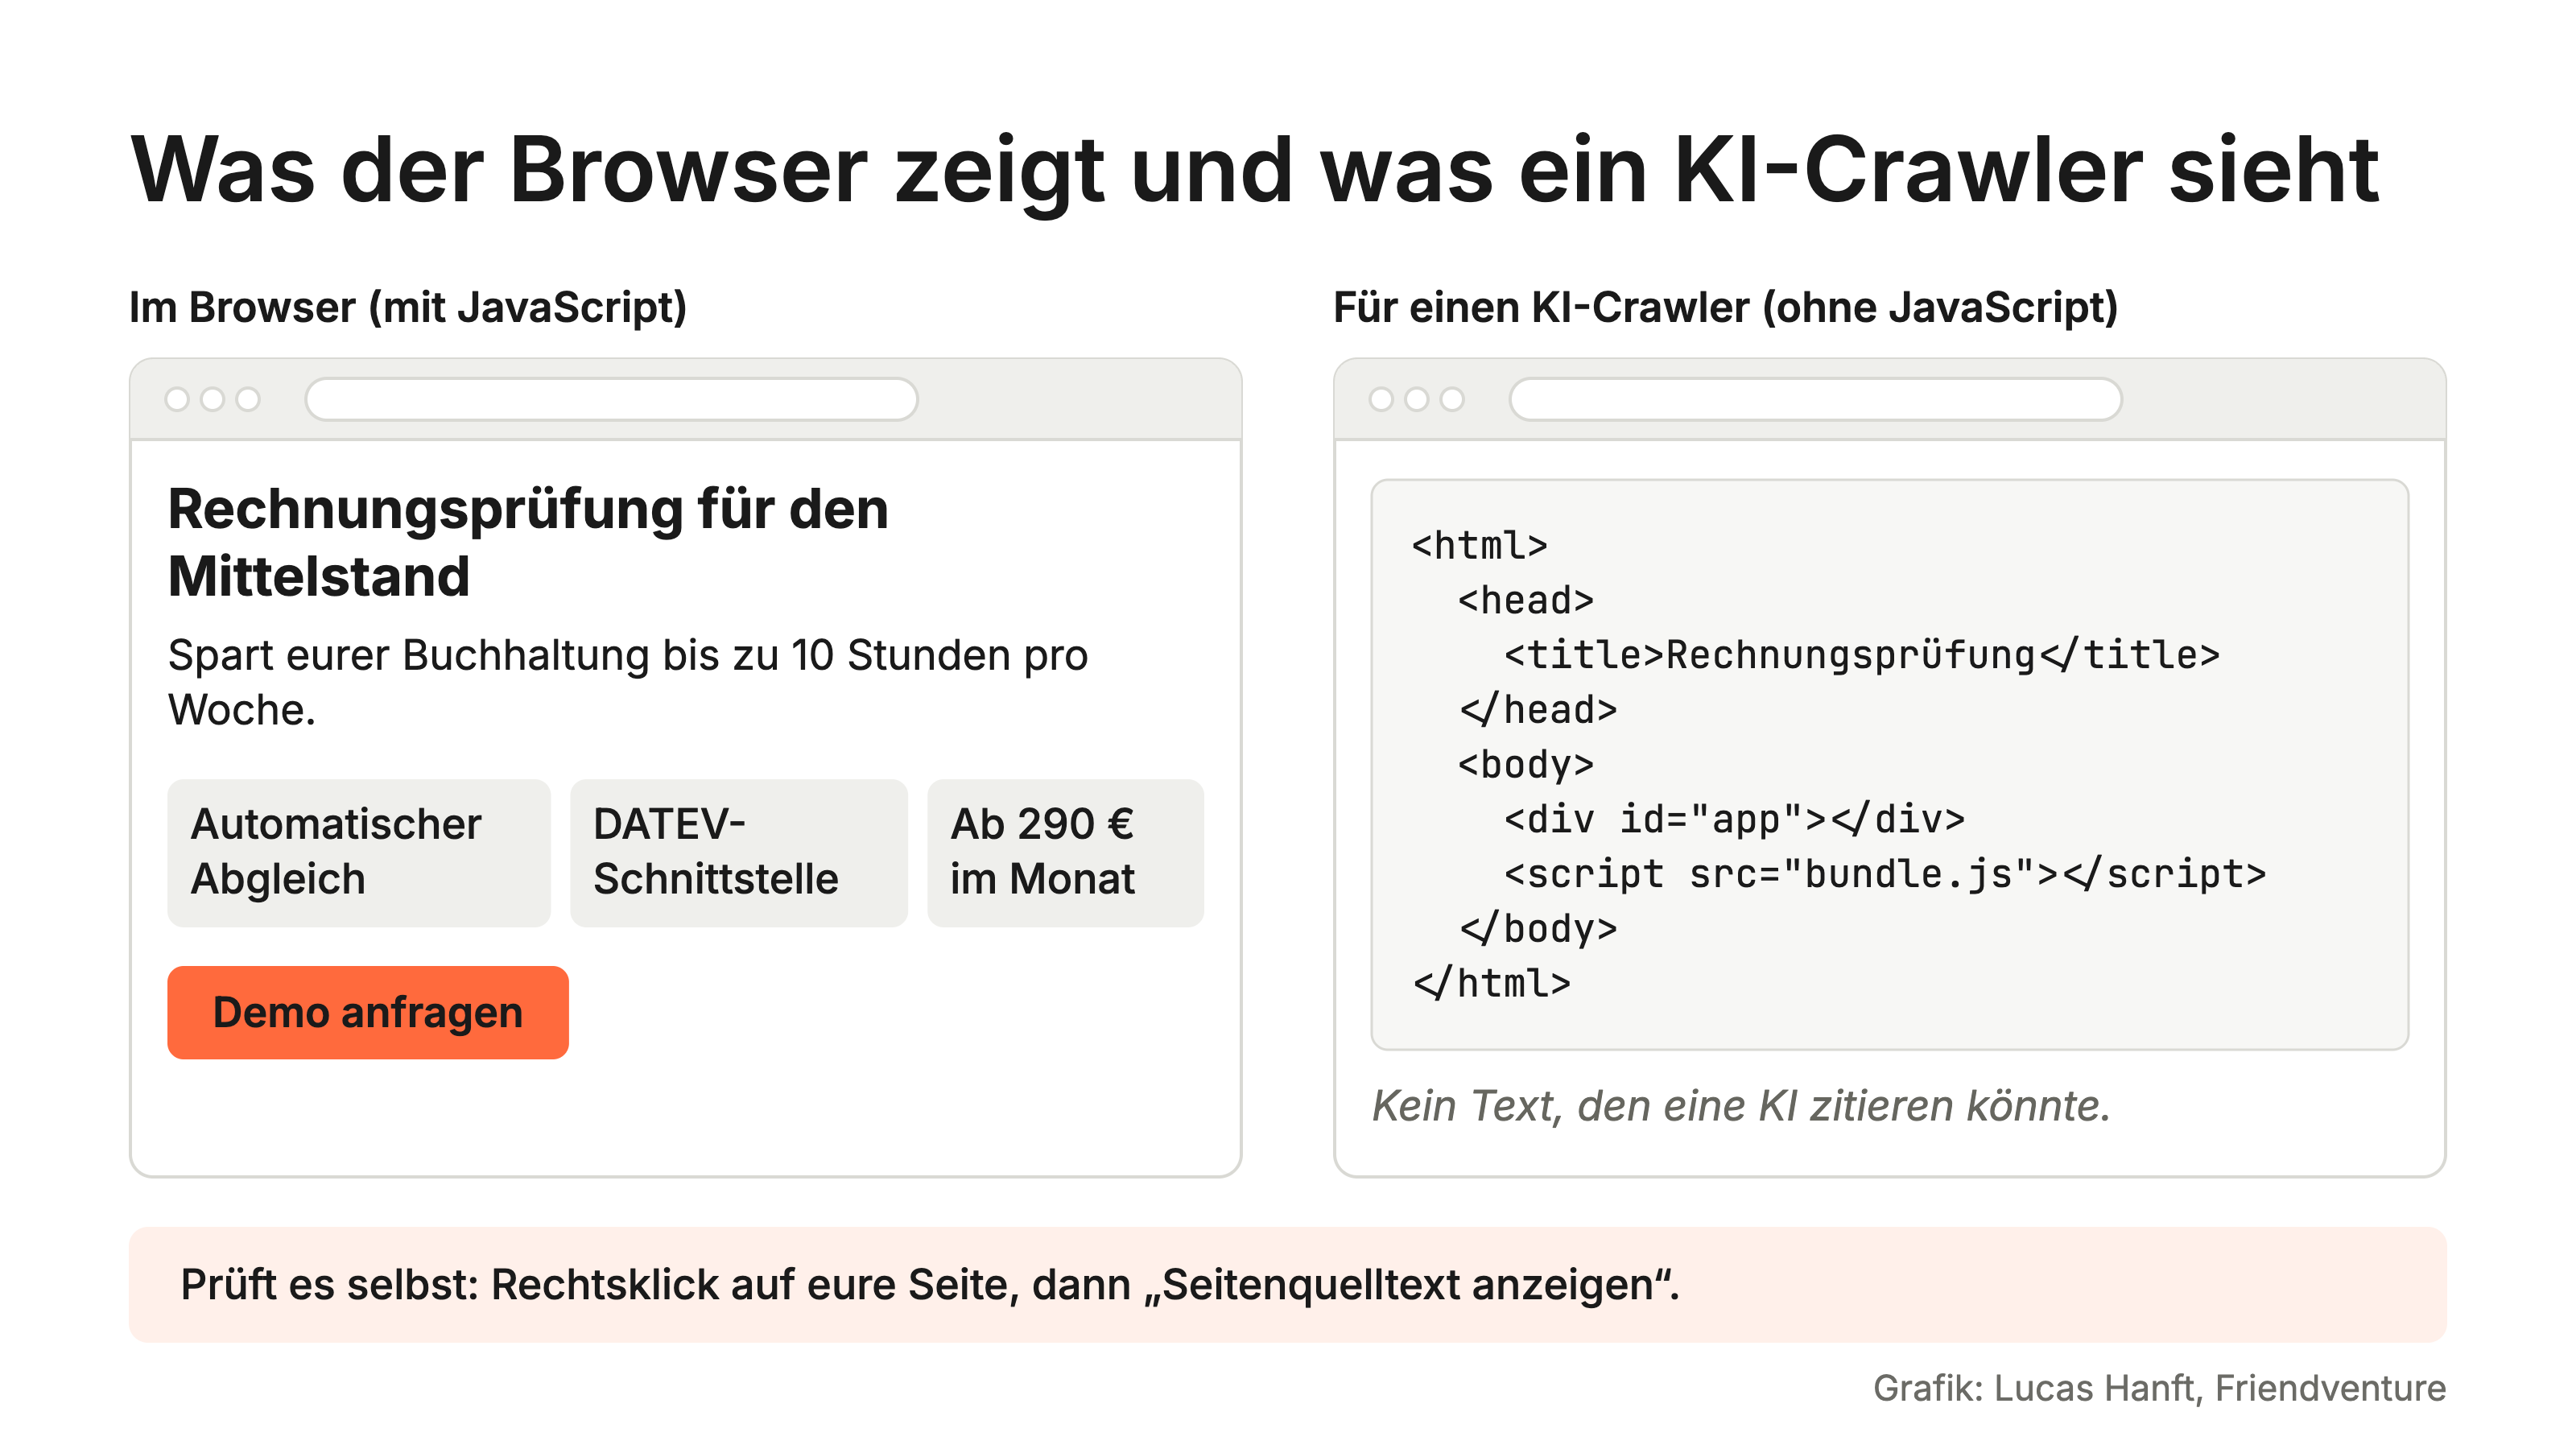
KI-Systeme nutzen eure Website auf zwei Wegen: als Trainingsmaterial und als Live-Quelle für aktuelle Antworten. Für beide Wege schicken die Anbieter eigene Crawler los, und die meisten davon führen kein JavaScript aus. Was nicht im ausgelieferten HTML steht, existiert für sie nicht.
Trainingsdaten sind Texte, aus denen ein Sprachmodell sein Grundwissen lernt. Was dort über eure Marke landet, prägt die Antworten langfristig, lässt sich aber kaum kurzfristig ändern. Wie das genau funktioniert, erklärt der bakedwith-Artikel über Large Language Models.
Der Live-Abruf ist für eure Sichtbarkeit meist wichtiger. Fragt jemand in ChatGPT oder Perplexity nach Anbietern, sucht das System in Echtzeit passende Seiten, liest sie aus und baut daraus die Antwort. Fachleute nennen das Retrieval Augmented Generation (RAG), also eine Antwort, die mit frisch abgerufenen Quellen angereichert wird. Wir bauen dieses Prinzip auch direkt in Websites ein, als semantische Suche über Seiten, PDFs und FAQs. Dabei lernt man schnell: Das Modell antwortet nur so gut, wie die Inhalte gegliedert sind. Für ChatGPT und Perplexity gilt dasselbe.
Die großen Anbieter trennen diese Aufgaben inzwischen sauber nach Crawlern:
Diese Trennung ist für eure robots.txt entscheidend, dazu gleich mehr in der Checkliste.
Das zweite Thema ist JavaScript. Googlebot rendert JavaScript seit Jahren, die meisten KI-Crawler tun das nach allem, was bisher bekannt ist, nicht. Baut eure Website ihre Inhalte erst im Browser zusammen, etwa bei manchen Single-Page-Anwendungen oder Produktkonfiguratoren, sieht ein KI-Crawler im Zweifel eine fast leere Seite. Wir halten das derzeit für den am meisten unterschätzten Grund, warum technisch moderne Websites in KI-Antworten fehlen.
Klassische CMS wie WordPress oder TYPO3 liefern Seiten standardmäßig als fertiges HTML aus und sind hier im Vorteil. Bei Headless-Setups, etwa mit Storyblok oder Contentful und einem JavaScript-Frontend, muss Server-Side Rendering bewusst eingeplant werden. Wir setzen beide Varianten um und klären diese Frage deshalb in Headless-Projekten ganz am Anfang, nicht erst kurz vor dem Livegang.
Ein Beispiel aus unserer Arbeit: Für den Energieversorger Mark-E haben wir die Website mit Storyblok als Headless-CMS umgesetzt, inklusive eines interaktiven Tarifrechners. Ein solcher Rechner braucht JavaScript, das lässt sich nicht vermeiden. Umso wichtiger ist, dass die Informationen drumherum als normaler Text auf der Seite stehen: Tarifarten, Preisgarantien, Boni und die häufigsten Fragen. Genau diese Passagen kann eine KI später zitieren, den Rechner selbst nicht.
Die technische KI-ready-Checkliste für 2026
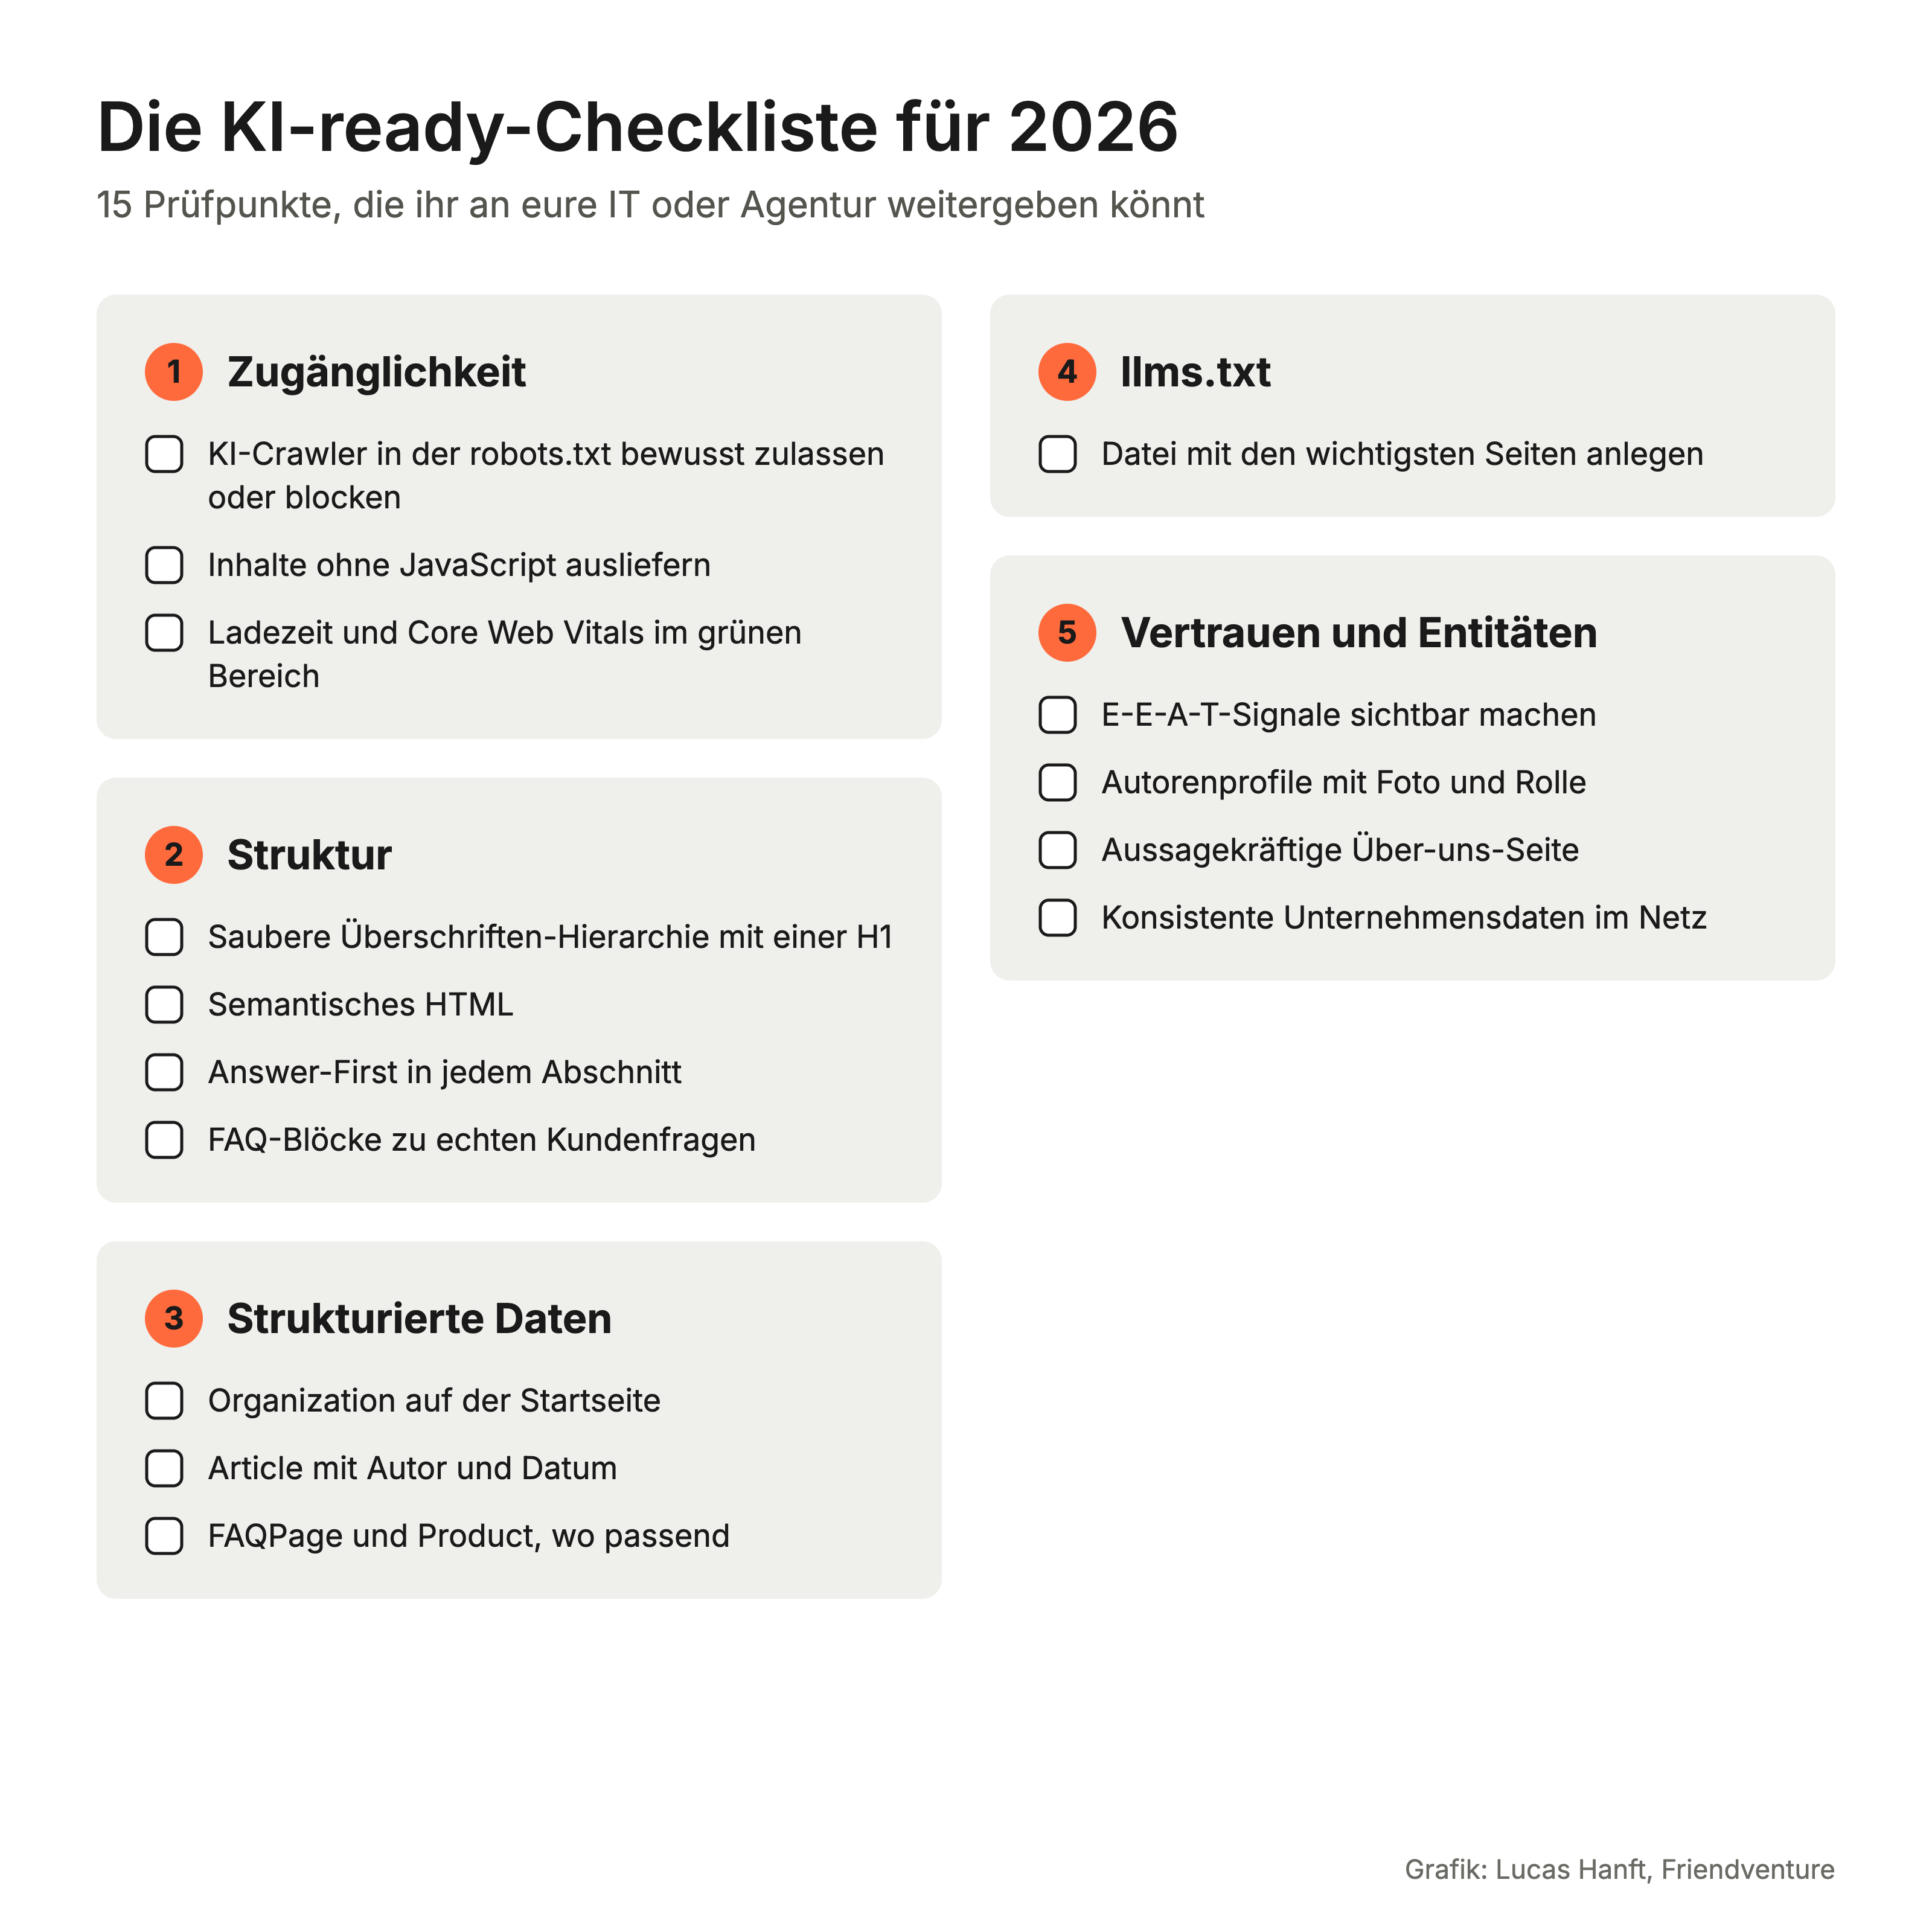
Die Checkliste deckt fünf Bereiche ab: Zugänglichkeit, Struktur, strukturierte Daten, llms.txt sowie Vertrauen und Entitäten. Jeder Punkt enthält, was zu tun ist, warum es für KI-Sichtbarkeit zählt und wie ihr es prüft. So könnt ihr jede Zeile direkt als Aufgabe an eure IT oder Agentur geben.
Die Reihenfolge ist bewusst gewählt. Bei den KI-ready Websites, die wir bei Friendventure umsetzen, arbeiten wir sie genau so ab, weil jeder Bereich auf dem vorherigen aufbaut.
Zugänglichkeit: robots.txt, Rendering, Core Web Vitals
Ohne Zugang ist alles andere wirkungslos. Diese drei Punkte entscheiden, ob KI-Crawler eure Inhalte überhaupt zu sehen bekommen.
Eine sinnvolle Grundeinstellung für die meisten B2B-Websites sieht so aus: Such-Crawler zulassen, beim Training selbst entscheiden.
User-agent: OAI-SearchBot
Allow: /
User-agent: Claude-SearchBot
Allow: /
User-agent: PerplexityBot
Allow: /
# Training: bewusst entscheiden
User-agent: GPTBot
Allow: /
Struktur: Überschriften, semantisches HTML, Answer-First, FAQ
KI-Systeme zitieren einzelne Passagen, keine ganzen Seiten. Je klarer eine Passage für sich allein funktioniert, desto eher wird sie übernommen. Dieser Artikel folgt übrigens selbst dem Prinzip: Jeder Abschnitt beginnt mit der Antwort, die Details kommen danach.
Strukturierte Daten: Schema.org (Organization, FAQPage, Article)
Strukturierte Daten liefern KI-Systemen Fakten in maschinenlesbarer Form: wer ihr seid, was ein Produkt kostet, wer einen Artikel geschrieben hat. Das Vokabular dafür kommt von schema.org und wird als JSON-LD in den Quelltext eingebaut.
So sieht ein schlankes Organization-Markup für die Startseite aus. Name, Adresse und Profile ersetzt ihr durch eure eigenen Angaben:
<script type="application/ld+json">
{
"@context": "https://schema.org",
"@type": "Organization",
"name": "Beispiel GmbH",
"url": "https://www.beispiel.de",
"logo": "https://www.beispiel.de/logo.png",
"address": {
"@type": "PostalAddress",
"addressLocality": "Köln",
"addressCountry": "DE"
},
"sameAs": [
"https://www.linkedin.com/company/beispiel-gmbh"
]
}
</script>
llms.txt: ehrliche Einordnung
Die llms.txt ist eine Textdatei im Hauptverzeichnis eurer Website, die KI-Systemen eine kuratierte Übersicht eurer wichtigsten Inhalte gibt. Sie ist nützlich, aber kein Hebel für mehr Sichtbarkeit. Nach aktuellem Stand hat keiner der großen Anbieter verbindlich bestätigt, dass er die Datei für Suchantworten auswertet.
Unsere Einschätzung: Legt sie an, weil es mit einer Stunde Aufwand erledigt ist und KI-Agenten sowie Entwicklertools sie teils schon lesen. Erwartet davon aber keine Wirkung auf eure Nennungen in ChatGPT. Wie die Datei aufgebaut ist, beschreibt die llms.txt-Spezifikation.
Vertrauen und Entitäten: E-E-A-T, Autorenprofile, konsistente Daten
KI-Systeme empfehlen Marken, die sie eindeutig erkennen und für glaubwürdig halten. Eine Entität ist dabei ein klar identifizierbares Objekt wie euer Unternehmen, das Suchsysteme im Knowledge Graph mit anderen Informationen verknüpfen. Widersprüchliche Angaben im Netz schwächen dieses Bild.
Priorisierung: Womit ihr anfangt
Fangt mit robots.txt und Rendering an, danach kommen Answer-First-Texte und strukturierte Daten. Die llms.txt steht bei uns ganz am Ende. Der Crawler muss eure Inhalte zuerst erreichen und verstehen können. Alles andere ist Feinschliff.
So schätzen wir Aufwand und Wirkung der einzelnen Maßnahmen ein:
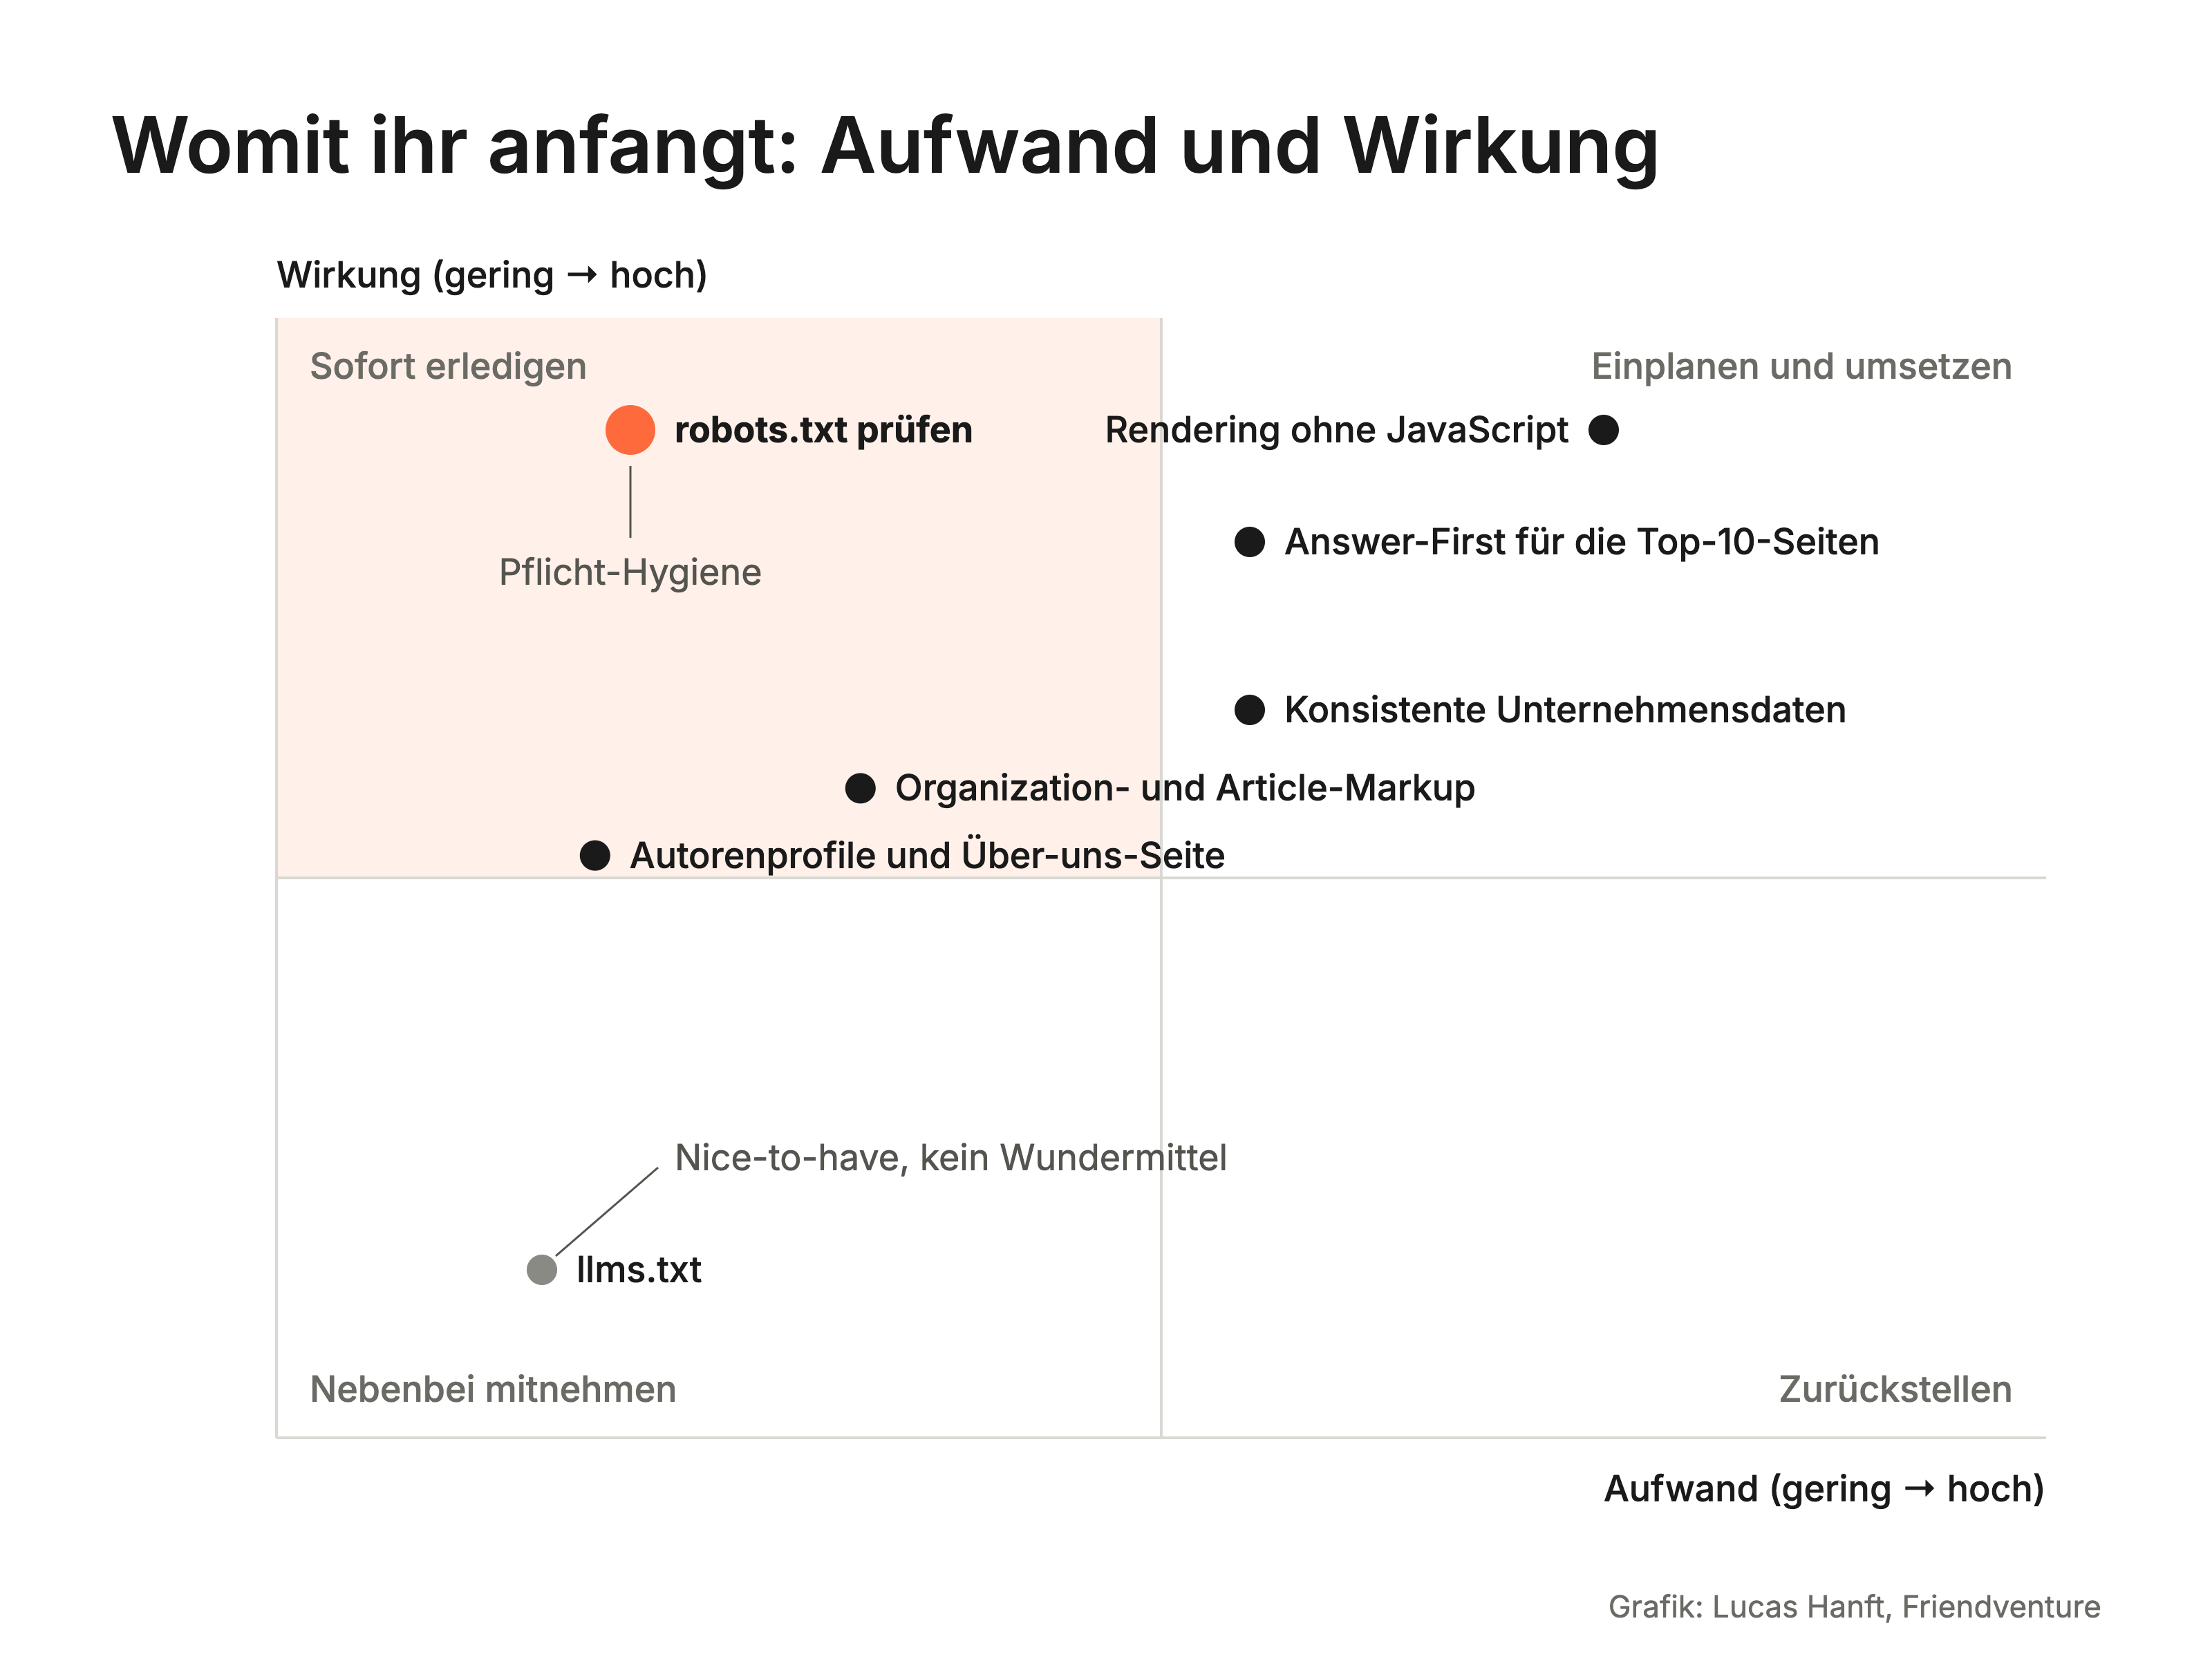
Wir sehen es so: Die meisten Unternehmen stecken zu viel Energie in Dinge, über die gerade viel gesprochen wird, und zu wenig in langweilige Grundlagen. Eine falsch konfigurierte robots.txt kostet euch mehr Sichtbarkeit, als eine perfekte llms.txt je bringen kann. Wie viel ein sauberes technisches Fundament ausmacht, haben wir beim Website-Relaunch für den Softwareanbieter FORCAM gesehen: Nach dem Relaunch ist die SEO-Sichtbarkeit deutlich gestiegen. Für KI-Sichtbarkeit gibt es noch keine vergleichbar etablierte Messgröße, sie beginnt aber an genau derselben Stelle.
KI-Sichtbarkeit prüfen: Der Quick-Check
Ob eure Website in KI-Antworten auftaucht, seht ihr am schnellsten mit einer Handvoll Test-Prompts und einem Blick in die Server-Logs. Für den ersten Eindruck braucht ihr kein Tool und etwa eine Stunde Zeit.
So geht ihr vor:
- Test-Prompts stellen. Formuliert fünf Fragen so, wie eure Kunden sie stellen würden, etwa „Welche Anbieter für [eure Leistung] gibt es in Deutschland?“ oder „Was ist [eure Marke] und für wen eignet sich das?“. Stellt sie in ChatGPT mit aktivierter Websuche und in Perplexity, am besten in einem temporären Chat ohne Verlauf.
- Antworten auswerten. Notiert, ob ihr genannt werdet, ob eure Website als Quelle verlinkt ist und ob die Beschreibung stimmt. Schaut auch, welche Quellen die KI stattdessen nutzt.
- Server-Logs prüfen. Lasst eure IT in den Zugriffsprotokollen nach OAI-SearchBot, ChatGPT-User, Claude-SearchBot und PerplexityBot suchen. Tauchen diese Crawler über Wochen nie auf, blockiert vermutlich etwas den Zugang.
- Referrer auswerten. Legt in Google Analytics 4 einen Filter auf Besuche von chatgpt.com, perplexity.ai und gemini.google.com an. So seht ihr, ob KI-Antworten schon Besuche bringen.
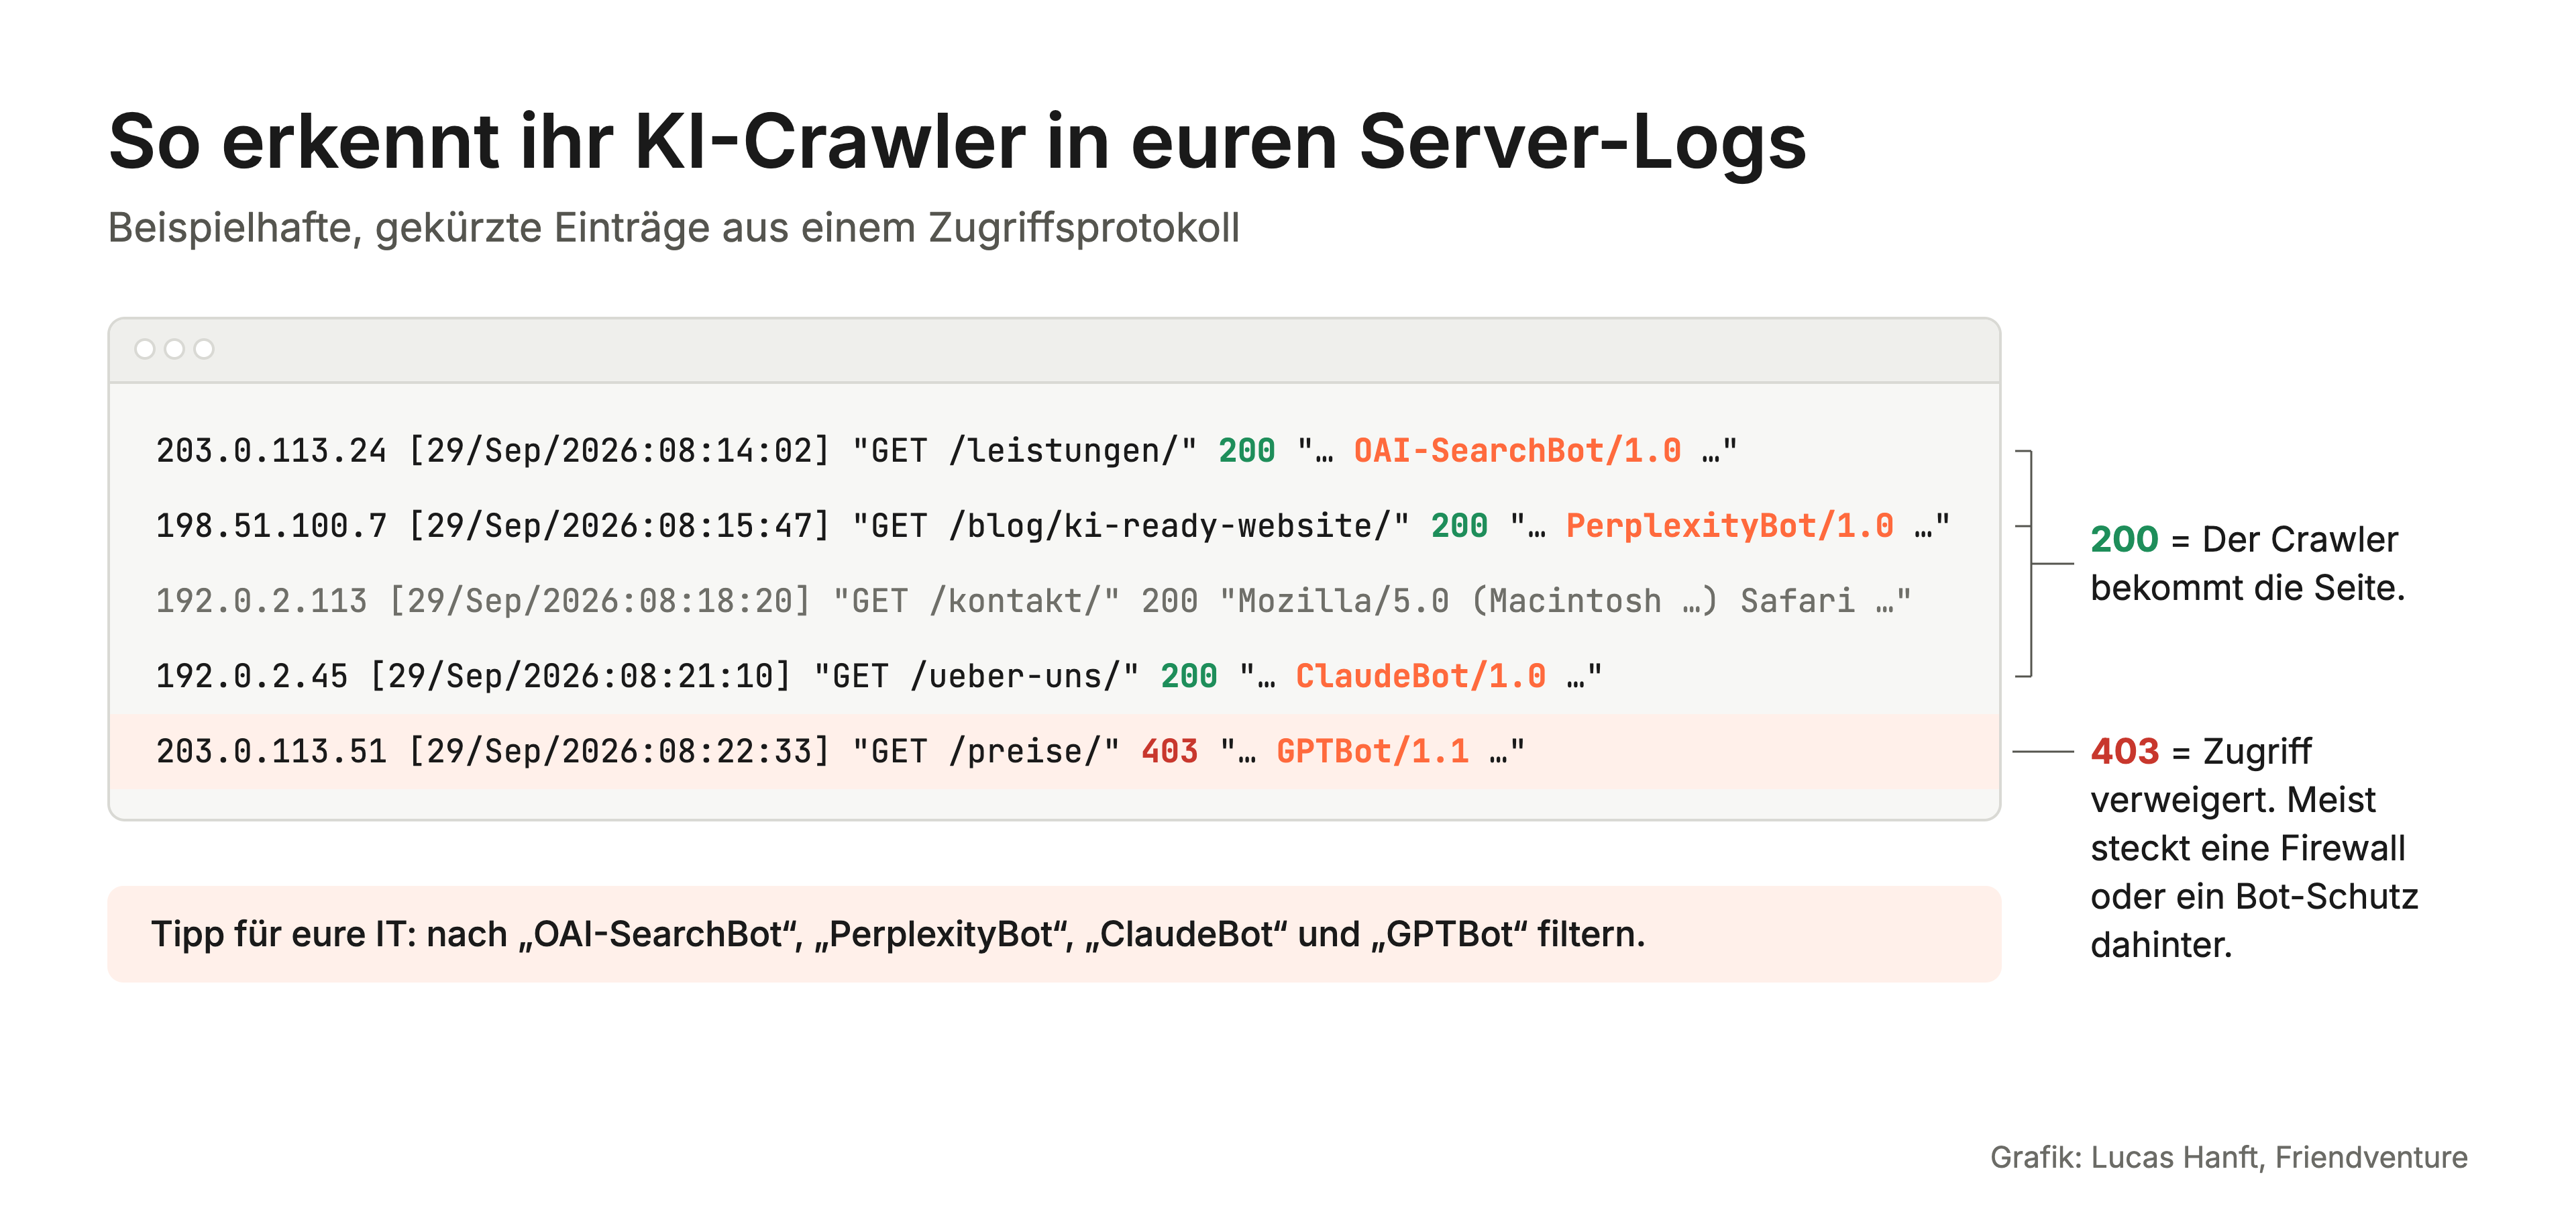
Ein grundsätzliches Problem erkennt ihr damit schnell. Für ein vollständiges GEO-Audit reicht das nicht: Bei Friendventure kombinieren wir dafür ein Monitoring-Tool wie Otterly.ai mit manueller Prüfung, weil Tools zwar Nennungen zählen, aber selten merken, wenn eine Beschreibung inhaltlich falsch ist. Für regelmäßiges Monitoring über viele Prompts hinweg gibt es spezialisierte KI-SEO-Tools. Wer strukturiert tiefer einsteigen will, findet in unserer GEO-Checkliste für KI-Sichtbarkeit weitere Prüfpunkte zu Technik, Content und Monitoring.
Diese Fehler machen Websites unsichtbar für KI
Die meisten Websites werden durch einzelne Einstellungen unsichtbar, die niemand im Blick hatte. Der tückischste davon ist der Bot-Schutz, weil er in keinem klassischen SEO-Tool auffällt. Diese Fehler solltet ihr ausschließen:
- Bot-Schutz im CDN: Content-Delivery-Netzwerke und Firewalls filtern automatisierte Zugriffe. Cloudflare etwa bietet eine Einstellung, mit der sich KI-Crawler per Klick komplett sperren lassen. Wer das irgendwann aktiviert hat, taucht in KI-Antworten nicht mehr auf, obwohl die robots.txt alles erlaubt. Wir setzen Cloudflare in Projekten selbst ein und raten deshalb: Schaut nach jedem Livegang und jedem größeren Sicherheits-Update in die Bot-Einstellungen.
- Pauschale Sperren in der robots.txt: Eine Regel gegen GPTBot aus Sorge vor Training ist legitim. Oft wird dabei aber OAI-SearchBot gleich mitgesperrt, und damit verschwindet die Website aus der ChatGPT-Suche.
- Zentrale Inhalte in Bildern oder PDFs: Preistabellen als Grafik, Leistungsbeschreibungen nur im PDF-Prospekt, Kennzahlen im Slider. KI-Crawler lesen solche Formate schlecht oder gar nicht. Stellt euch einen Maschinenbauer vor, dessen Leistungsdaten nur im PDF-Datenblatt stehen. Fragt jemand ChatGPT nach Anlagen mit genau dieser Leistung, fehlt der Hersteller in der Antwort, obwohl er das passende Produkt hat.
- llms.txt als Wundermittel: Die Datei wird angelegt, und damit gilt das Thema als erledigt. An der eigentlichen Sichtbarkeit ändert das wenig.
- Fehlende Struktur: Lange Textblöcke ohne Zwischenüberschriften, die wichtigste Aussage am Ende. Für ein System, das einzelne Passagen sucht, bleibt nichts Zitierfähiges übrig.
- Veraltete Fakten: Alte Preise, frühere Standorte oder eingestellte Produkte auf der Website oder in Verzeichnissen. KI-Systeme übernehmen diese Angaben und geben sie weiter.
Fazit: KI-ready ist kein Projekt, sondern ein Standard
Eine KI-ready Website entsteht durch Grundlagen, die ihr dauerhaft pflegt. Ein einmaliger Relaunch reicht dafür nicht. Neue Crawler kommen dazu, und eure Inhalte veralten schneller, als man denkt. Wer die Checkliste zweimal im Jahr durchgeht, bleibt auf der sicheren Seite. Dazu gehört etwas Gelassenheit: Die KI-Anbieter legen ihre Auswahlkriterien nur teilweise offen, und nicht jede Schwankung in den Antworten lässt sich erklären. Wir raten deshalb, die Energie in die Grundlagen zu stecken, die ihr selbst in der Hand habt.
Für den Start reichen drei Schritte: robots.txt und Bot-Schutz prüfen, den Seitenquelltext eurer wichtigsten Seiten ansehen und fünf Test-Prompts stellen. Das kostet einen Nachmittag und zeigt euch, ob ihr ein grundsätzliches Problem habt oder nur Feinschliff braucht.
Dieser Artikel behandelt bewusst nur die Website. Wie ihr euer Team auf die Arbeit mit KI-Tools vorbereitet, lest ihr im bakedwith-Beitrag zum KI-ready Team. Und wer die Umsetzung lieber abgeben will, findet eine Übersicht der GEO-Agenturen in Deutschland.
FAQ
Was bedeutet „KI-ready“ bei einer Website?
Eine KI-ready Website können KI-Systeme wie ChatGPT, Perplexity und Google AI Overviews technisch abrufen, inhaltlich verstehen und als Quelle zitieren. Dazu gehören offener Zugang für KI-Crawler, Inhalte ohne JavaScript-Abhängigkeit, klare Struktur, strukturierte Daten und eine eindeutig erkennbare Marke.
Wie optimiere ich meine Website für ChatGPT und andere KI-Suchmaschinen?
Stellt zuerst sicher, dass OAI-SearchBot und andere Such-Crawler in der robots.txt erlaubt sind und eure Inhalte im HTML-Quelltext stehen. Formuliert danach die wichtigsten Seiten nach dem Answer-First-Prinzip und ergänzt strukturierte Daten nach schema.org. Prüft das Ergebnis regelmäßig mit Test-Prompts.
Was ist der Unterschied zwischen SEO und GEO?
SEO zielt auf gute Positionen in einer Trefferliste. GEO zielt darauf, in den fertigen Antworten von KI-Systemen genannt und zitiert zu werden. GEO baut auf SEO auf, braucht aber zusätzlich Zugang für KI-Crawler, zitierfähige Passagen und klare Entitätssignale.
Braucht jede Website eine llms.txt-Datei?
Nein, zwingend ist sie nicht. Die Datei ist ein Vorschlag, den bisher kein großer Anbieter verbindlich für seine Suchantworten nutzt. Wir empfehlen sie trotzdem, weil sie wenig Aufwand macht, aber sie gehört ans Ende der Prioritätenliste.
Soll ich KI-Crawler blockieren oder zulassen?
Für die meisten B2B-Unternehmen gilt: Such-Crawler wie OAI-SearchBot, Claude-SearchBot und PerplexityBot zulassen, weil ihr sonst in den Antworten fehlt. Ob ihr Trainings-Crawler wie GPTBot oder ClaudeBot zulasst, ist eine bewusste Abwägung zwischen Reichweite und Kontrolle über eure Inhalte.
Wie finde ich heraus, ob meine Website in KI-Antworten auftaucht?
Stellt in ChatGPT und Perplexity Fragen, die eure Kunden stellen würden, und prüft, ob ihr genannt und verlinkt werdet. Ergänzend zeigen Server-Logs, ob KI-Crawler eure Seiten besuchen, und Google Analytics 4, ob Besuche von chatgpt.com oder perplexity.ai kommen.
Geschrieben von:
Lucas Hanft ist Werkstudent bei der Digitalagentur Friendventure mit Hauptsitz in Köln. Er verbindet Marketingwissen mit Storytelling und entwickelt Inhalte, die in Google und in KI-Suchmaschinen sichtbar werden. Seit 2 Jahren beschäftigt er sich intensiv mit Generative Engine Optimization und damit, wie Websites technisch und inhaltlich für KI-Systeme lesbar werden.